Краткий ответ
При выборе VPS/VDS определите модель, способ вычислений и потребность в памяти, включая VRAM при использовании GPU. Обычный VPS не гарантирует наличие ускорителя или достаточную скорость inference; уточните оборудование и протестируйте свою модель.
Для множества задач — текстовая генерация малых моделей, классификация, рекомендательные системы, компьютерное зрение среднего уровня — достаточно правильно настроенного VPS с мощным CPU и грамотной архитектурой. Главная задача — оптимизация инференса, распределение нагрузки и контроль затрат.
Ниже — практический рейтинг VPS 2026 для AI-проектов без GPU с разбором конфигураций, цен и сценариев использования.
Когда можно обойтись без GPU
GPU необходимы для обучения больших моделей. Но для инференса малых LLM, embedding-моделей, OCR, чат-ботов, рекомендательных систем часто достаточно:
-
8–16 vCPU (современные Xeon/EPYC)
-
32–64 ГБ RAM
-
NVMe SSD
-
1 Гбит/с
Оптимизация достигается за счёт:
-
квантования моделей
-
batch-обработки
-
очередей задач
-
горизонтального масштабирования
1 место — Timeweb Cloud
Баланс цены и производительности.
Параметры:
-
AMD EPYC
-
NVMe
-
1 Гбит/с
-
SLA 99,9%
Цена от ~5000–8000 руб./мес.
Подходит для:
-
AI-API
-
embedding-сервисов
-
SaaS-чатов
2 место — Selectel
VPS Selectel с бонусом 10000 руб
Корпоративный уровень для CPU-инференса.
Характеристики:
-
Intel Xeon Gold / AMD EPYC
-
NVMe корпоративного уровня
-
1–10 Гбит/с
-
SLA 99,98%
-
несколько дата-центров
Цены:
-
8 vCPU / 16 ГБ — ~9000–12 000 руб./мес
-
16 vCPU / 32 ГБ — ~18 000 руб./мес
Преимущества:
-
высокая частота CPU
-
стабильный I/O для моделей
-
удобно масштабировать через API
-
подходит для Docker и микросервисов
Промокод для новых клиентов: qhD5Uqoi0E на 10 000 руб.
3 место — EdgeCenter
VPS EdgeCenter с бонусом 500 руб
Сильная сеть и международные локации.
Особенности:
-
NVMe
-
1–10 Гбит/с
-
европейские ДЦ
-
защита от DDoS
Цена ~6000–12 000 руб./мес.
Подходит для AI-сервисов с глобальной аудиторией.
4 место — VDSina
Бюджетный, но гибкий вариант.
Характеристики:
-
KVM
-
NVMe
-
1 Гбит/с
-
низкая стоимость
Цена ~2000–4000 руб./мес.
Подходит для:
-
отдельных AI-воркеров
-
тестирования моделей
-
staging-инференса
-
dev-среды
Можно запускать несколько VPS и распределять задачи по очереди.
5 место — SpaceWeb
Стабильная платформа среднего сегмента.
Параметры:
-
NVMe
-
до 64 ГБ RAM
-
SLA 99,9%
-
1 Гбит/с
Цена ~4000–7000 руб./мес.
Подходит для:
-
backend AI-сервисов
-
API-платформ
-
микросервисной архитектуры
6 место — AdminVPS
-
NVMe
-
KVM
-
1 Гбит/с
-
гибкие тарифы
Цена ~2500–5000 руб./мес.
Хорош для:
-
отдельных inference-нод
-
фоновых AI-процессов
-
микросервисов
7 место — Sprintbox
-
NVMe
-
1 Гбит/с
-
быстрое развертывание
Цена ~2000–3500 руб./мес.
Используется для:
-
отдельных batch-задач
-
очередей
-
временных вычислительных нод
8 место — Hostland
-
NVMe
-
SLA 99,9%
-
базовая защита
Цена ~2500–4000 руб./мес.
Подходит для:
-
API-обёрток над моделями
-
хранения эмбеддингов
-
вспомогательных сервисов
9 место — HandyHost
-
KVM
-
NVMe
-
1 Гбит/с
Цена ~1500–3000 руб./мес.
Используется для:
-
dev-инференса
-
тестирования пайплайнов
-
мониторинга
10 место — FirstVDS
-
NVMe
-
1 Гбит/с
-
минимальная стоимость
Цена ~1200–2500 руб./мес.
Подходит для:
-
прототипов
-
тестовых AI-сервисов
-
резервных узлов
Оптимизация CPU-инференса
Чтобы избежать покупки GPU:
-
Используйте квантованные модели (int8/int4).
-
Разносите инференс по очередям (Redis/RabbitMQ).
-
Делайте batch-обработку.
-
Кэшируйте повторяющиеся запросы.
-
Разделяйте API и вычислительные узлы.
Архитектура AI-стартапа без GPU
Минимальная схема:
-
VPS #1 — API-шлюз
-
VPS #2 — очередь задач
-
VPS #3 — inference-воркеры
-
VPS #4 — база данных
Такой подход дешевле GPU-сервера и масштабируется горизонтально.
Очереди задач и асинхронная архитектура
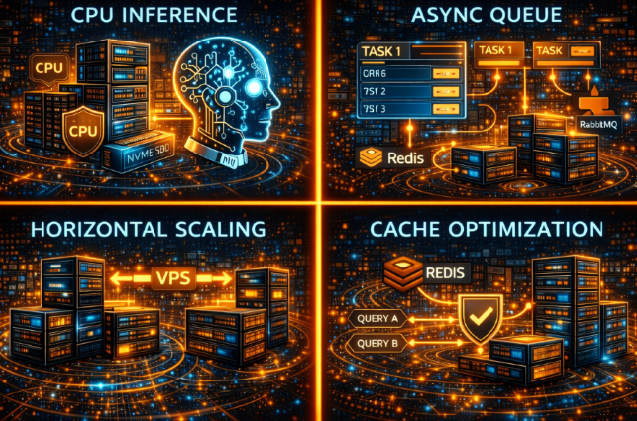
Ключевая ошибка AI-стартапов без GPU — выполнять инференс прямо в основном API-процессе. Это приводит к блокировке потоков, росту задержек и падению сервиса при пиковых нагрузках. Правильная архитектура всегда асинхронная.
Базовая схема:
-
Клиент отправляет запрос в API.
-
API кладёт задачу в очередь (Redis, RabbitMQ, Kafka).
-
Отдельные worker-ноды забирают задачи и выполняют инференс.
-
Результат возвращается пользователю через polling или callback.
Такой подход позволяет:
-
масштабировать только inference-воркеры
-
удерживать API-слой стабильным
-
контролировать пиковую нагрузку
-
избегать падения всей системы при перегрузке CPU
Для очередей достаточно отдельного VPS с 2–4 vCPU и 8–16 ГБ RAM. Основная нагрузка приходится на воркеры.
Горизонтальное масштабирование вместо GPU
GPU-сервер стоит дорого и создаёт точку отказа. CPU-инференс на нескольких VPS дешевле и гибче.
Пример:
Один GPU-сервер — 80–150 тыс. руб./мес.
Три VPS по 16 vCPU — 45–60 тыс. руб./мес.
При этом:
-
можно отключать лишние ноды ночью
-
масштабировать по мере роста аудитории
-
распределять нагрузку по регионам
-
обновлять модели без полного простоя
Горизонтальная архитектура позволяет постепенно наращивать инфраструктуру без крупных вложений.
Кэширование и оптимизация запросов
AI-сервисы часто обрабатывают повторяющиеся запросы. Если не внедрить кэш, CPU будет работать впустую.
Рекомендуется:
-
использовать Redis для кэширования результатов
-
хранить embeddings отдельно
-
применять дедупликацию запросов
-
ограничивать частоту запросов от одного пользователя
Кэширование снижает нагрузку до 30–60% при повторяющихся сценариях.
Контроль затрат
AI-стартапы часто сталкиваются с тем, что инфраструктура начинает «съедать» маржу. Чтобы этого избежать:
-
Мониторьте загрузку CPU.
-
Выключайте неиспользуемые воркеры.
-
Разделяйте production и dev.
-
Не держите избыточную RAM.
-
Используйте auto-scaling через скрипты или API провайдера.
Многие проекты переплачивают за ресурсы из-за страха перегрузки. Реальная средняя загрузка редко превышает 50–60%.
Когда всё же нужен GPU
CPU-инференс подходит для:
-
LLM до 7–13B с квантованием
-
классификации
-
чат-ботов
-
OCR
-
рекомендательных моделей
GPU становится оправданным при:
-
обучении моделей
-
генерации изображений
-
видео-генерации
-
работе с крупными LLM 30B+
Но даже в этих случаях можно гибридно использовать CPU для API-логики и GPU только для узкого слоя задач.
Итоговая стратегия для AI без GPU
Правильная инфраструктура строится по принципу модульности:
-
API отдельно
-
очередь отдельно
-
воркеры отдельно
-
база данных отдельно
Лучшие VPS 2026 для AI без GPU — это решения с высокой частотой CPU, стабильным NVMe и возможностью быстро добавлять новые узлы.
В 2026 году выигрывает не тот, у кого самый дорогой сервер, а тот, кто умеет строить масштабируемую архитектуру. CPU-инференс при грамотной оптимизации позволяет запустить AI-сервис с минимальными вложениями и расти по мере увеличения аудитории.
Что проверить для этого проекта
- Совместимость модели, библиотек и оборудования
- Память модели и параллельные запросы
- Очередь, лимиты, стоимость вычислений и доступ к данным
Вопрос по выбору VPS/VDS
Нужен ли GPU для каждого ИИ-приложения?
Нет. Приложение может обращаться к внешнему API или выполнять небольшую модель на CPU. Требования определяются выбранной моделью и допустимым временем ответа, а не названием проекта.
Может быть интересно:
- VDS 2026 для compute-heavy backend задач: оптимизация CPU-интенсивных вычислений без GPU
- Лучшие VPS 2026 для обучения и инференса LLM: GPU-мощности и тензорные вычисления.
- Лучшие VPS 2026 для автоматизации бизнеса и RPA: очереди задач, обработка PDF и CPU-нагрузка
- VPS 2026 для AI-генерации контента: рендеринг, batch-задачи и CPU-нагрузка без GPU
- VPS 2026 для background job processing: очереди задач, cron-системы и распределенные воркеры
- Мощность для интеллекта: Рейтинг лучших VPS 2026 для запуска AI-моделей и инференса
- VDS 2026 для ускорения работы серверных процессов: оптимизация выполнения задач
- VDS 2026 для автоматического удаления неиспользуемых ресурсов: экономия и чистота системы
- Дешевый хостинг для сайта: когда экономия оправдана, а когда опасна
- Почему экономия на хостинге может привести к потере прибыли сайта